Kafka
▶ 什么是kafka?
• kafka(全名Apache Kafka),是一个用来处理消息的系统,就像一个信息中转站或者快递分发中心,负责“收消息、存消息、转消息。
• kafka就是一个高性能的消息队列系统,用来在系统与系统之间传递数据,而且还能保证**不丢、不乱、速度快** 。(面试问题)
▶ 为什么能够保证数据,不丢、不乱、速度快?
• 不丢
消息丢失会发生在三个环节:
生产者发送途中,Kafka服务端,消费者消费阶段
1.生产者:**acks应答机制**
生产者发送消息后等待broker返回确认
acks=all:最高可靠。必须等到Leader+所有同步副本(ISR)全部写完,才返回成功。
2.Broker集群(Kafka服务器):**副本机制Replication**
每个分区会有多份副本:
1个Leader:所有读写请求都走Leader
N个Follower:被动同步Leader的数据
只要ISR(正常同步的副本集合)里面至少有一个副本存活,这条消息就不会丢。并且消息持久化落盘,不会只放在内存,Kafka重启消息也不会消失
3.Consumer消费者(接收消息一方):**Offset偏移量**
Offset就是消息的编号,记录消费者读到哪一条消息
消费者先消费消息,消费成功之后再提交offset
如果消费者中途崩溃重启,就会从上一次已经提交的offset重新读取消息,消息不会漏掉
• 不乱
**核心铁律:**
Kafka只能保证同一个分区内部消息有序。Topic全局所有消息不能保证有序
**通俗解释:**
一个分区=**单车道马路** ,车辆(消息)只能排成一队依次通行,先进先出
FIFO先进先出机制,顺序不会乱
• 速度快
1.磁盘顺序追加写(**最核心** )
普通程序随机写硬盘,一会写文件A,一会写文件B,磁头来回跳转,很慢
**Kafkau永远只往日志文件末尾追加数据,绝不修改、删除已经写完的旧消息**
顺序写磁盘的性能几乎接近内存读写
2.零拷贝
磁盘缓存数据直接从内核发送到网卡,大幅减少CPU拷贝开销
3.批量收发
生产者不会发一条消息就网络请求一次,会赞一批消息打包一次性发送。
消费者也一次拉取一批消息。极大降低网络来回次数。
4.分区水平扩容
一个主题拆分成多个分区,多个分区可以部署在不同服务器,读写并行,吞吐量可以横向往上堆。
▶ Kafka有什么作用(它解决了哪些问题)?
问题| Kafka 怎么解决
---|---
🔄 系统之间耦合严重| Kafka 作为中间层,各系统不直接对接
🧱 数据量大、处理不过来| Kafka 支持高吞吐量,每天处理亿级消息不成问题(QPS大约为1500,一秒处理大约1500个请求)
🔁 消息丢失、顺序错乱| Kafka 有持久化机制、顺序消费、确认机制
🐢 有的系统处理慢| Kafka 支持异步处理,系统慢没关系,数据不会丢
📦 多系统都要相同数据| Kafka 支持发布-订阅模型,一次发,多个系统都能拿到
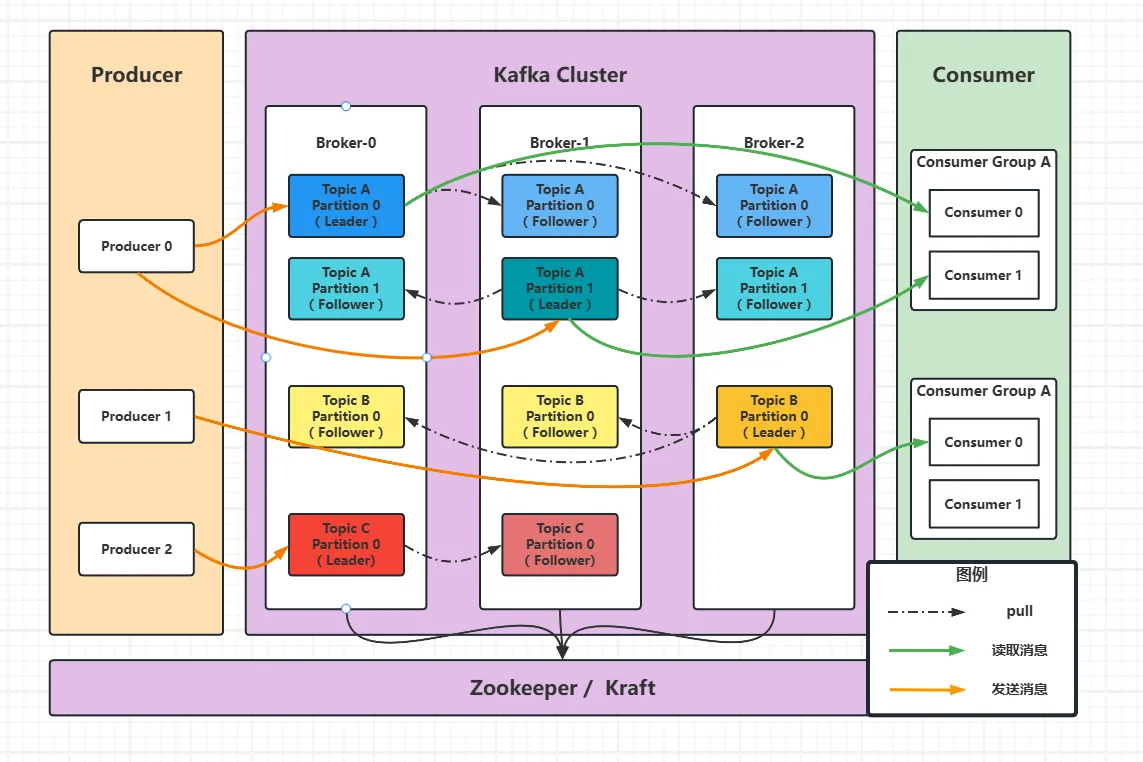
▶ 架构图
▶ 核心概念
• Topic(主题)
▪ 所有消息必须属于某个Topic
▪ 比如:订单、日志、支付,都是不同的Topic
**▪ 一个主题就是一类快递,真正存储数据的是它下面的分区**
• Partition(分区)
**▪ 每个Topic可以有多个Partition**
▪ 消息会被分布存储在这些分区中,提高并行度
▪ 每个分区内部是有序的队列,但多个分区之间无顺序保证
▪ 相当于是一类订单的货架(Topic),又拆成3个并排小格子(分区)
• Offset(偏移量)
▪ 每条消息在Partition中都有一个唯一编号,叫offset
▪ 消费者通过offset来记录自己读到那哪里了
▪ Kafka不会强制删除offset,而是由消费者自己控制读取进度,**如果消费者程序崩掉重启,就从上次提交的offset位置继续往下读,不会从头重消费全部消息**
**▪ 两个完全不一样的Offset:**
1.消息自身偏移量(分区内编号,只读):消息天生带的编号,永远不变
2.消费者提交的消费偏移量:记录这个消费组读到哪一条消息了
• Producer(生产者)
**▪ 把数据发到指定Topic,可以指定发到哪个Partition**
▪ 支持同步/异步发送,也可以配置是否要“确认消息写入成功”
• Consumer(消费者)
▪ 多个Consumer可以组成一个组,共同消费一个Topic
▪ Kafka会自动分配Partition给组内成员,每个分区只会被一个组内成员消费
▪ 不同组之间互不干扰,可以重复消费同一个消息
**▪ 消费者主动拉取消息,不是broker推送**
• Consumer Group(消费组)
▪ 一组消费者的集合
**▪ 同一个消费组内,一个分区最多只能被组里1个消费者读取**
• Broker(Kafka节点)
▪ Kafka集群中一个Broker就是一台Kafka服务器
▪ 多个Broker构成集群,共同存储Topic的Partition
▪ 每个Partition会有一个Leader(主分区)和若干Follower(副本),由不同Broker管理
• Replication(副本机制)
▪ 每个Partition可以配置副本数量,比如3个
▪ 1个Leader+2个Follower,用于故障时自动切换
▪ 保证高可用
**▪ Leader(首领副本):所有读写,只找Leader**
**▪ Follower(跟随副本):不处理读写,默默同步Leader,一旦Leader宕机,Kafka马上挑一个健康的Folower升级成新Leader**
• Retention(保留策略)
▪ Kafka会根据时间或大小来保留消息,比如保存7天或10GB
▪ Kafka是日志型系统,不会自动删除已消费消息,除非超过保留期
• Kafka Controller(主控器)
▪ 负责协调Broker的分配、Partition的选主、元数据管理等
▪ Kafka早期依赖ZooKeeper,后来逐步改为自管理(KRaft模式)
▶ Offset属于消费组
• 消费者如何提交offset
1.想要Kafka帮你持久化保存、提交offset,就必须指定group.ip(消费组编号)
2.一个消费组里面可以放1个或多个消费者。单消费者项目最常见的做法就是:消费组里就1个工人
• 必须指定消费组编号核心根因
▪ 最核心根因:Offset属于消费组,不属于消费者进程
如果没有group.id,那条进度记录就**没有归属人** ,Kafka不知道这个进度该给谁保存,**所以无法持久化提交offset**
• 举例
Topic=货架;Partition=格子;消息=包裹;offset=取件编号
消费组=一整个分拣工作队
offset是整个工作队的工作进度,不是某一个临时工的进度
**例子:**
工作队A(group-A)有3个分拣员(消费者C1,C2,C3),分别负责3个格子
C1读到offset=100,提交进度
**此时进度属于整个工作队A** ,不是属于C1这个人
如果C1机器崩了、人跑路了,工作队A再来一个新员工C4,就接着offset=100继续干活,不会从头再来一遍
▶ 总结表格
名称| 类型| 简要说明
---|---|---
Producer| 组件| 消息的发送者
Consumer| 组件| 消息的接收者
Topic| 概念| 消息的逻辑分类
Partition| 概念| Topic 的子单元,提高并发
Offset| 概念| 每条消息的编号
Consumer Group| 概念| 多消费者协作消费
Broker| 组件| Kafka 节点,存储数据
Controller| 组件| 管理集群和分区状态
Replication| 机制| 副本保证高可用
Retention| 机制| 消息保存策略
▶ 搭建Kafka集群
• 下载官方安装包
▪ 官方下载地址:
https://kafka.apache.org/downloads
▪ 解压到opt目录下
▪ **重点:**
可以创建一个软链接,这样后续版本更迭更方便
ln -s /opt/kafka_2.13-3.9.2 /opt/kafka
之后版本变化之后:
**先停止服务:/opt/kafka/bin/kafka-server-stop.sh**
ln -sf /opt/kafka_2.13-4.0.0 /opr/kafka
• 安装java环境(3台都要)
dnf install java-17-openjdk -y
java -version
• 部署Zookeeper集群(3台都需要)
1.创建目录:
mkdir -p /opt/lafka/data/zookeeper
2.配置zookeeper.properties文件:
vim /opt/kafka/config/zookeeper.properties
dataDir=/opt/kafka/data/zookeeper #数据存储目录
clientPort=2181 #客户端连接端口
maxClientCnxns=0 #最大客户端连接数。0表示无上限
tickTime=2000 #基本时间单元,毫秒为单位
initLimit=5 #初始化连接超时时间,fllower连接并同步到leader的初始化时间,计算公式:5×2000ms=10s
syncLimit=2 #心跳同步超时时间,leader与follower之间进行心跳检测的超时时间,计算公式:2×2000ms=4s
**格式:server. <myid>=<hostname>:<port1>:<port2>**
<myid>:服务器ID
<hostname>:服务器IP或主机名
<port1>:集群内部通信端口(follower连接leader用)
<port2>:选举端口(leader选举时使用)
server.1=10.0.1.21:2888:3888 #第一个节点
server.2=10.0.1.22:2888:3888 #第二个节点
server.3=10.0.1.23:2888:3888 #第三个节点
3.每台机器创建myid文件:
echo 1 > /opt/kafka/data/zookeeper/myid #node01
echo 2 > /opt/kafka/data/zookeeper/myid #node02
echo 3 > /opt/kafka/data/zookeeper/myid #node03
4.启动Zookeeper
cd /opt/kafka
bin/zookeeper-server-start.sh -daemon config/zookeeper.properties
5.确认监听
ss -tunlp | grep 2181
• 部署Kafka
1.创建kafka数据集
mkdir -p /opt/kafka/data/kafka
2.修改配置文件
vim /opt/kafka/config/server.properties
#每个节点配置不同的broker.id和监听地址
broker.id=1
log.dirs=/opt/kafka/data/kafka
zookeeper.connect=node01:2181,node02:2181,node03:2181
3.启动kafka
cd /opt/kafka
./bin/kafka-server-start-sh -daemon config/server.properties
• 验证集群状态
查看所有Broker信息
./bin/kafka-broker-api-versions.sh --bootstrap-server node01:9092
▶ Kafka的常见运维操作
• 集群管理
▪ 启动集群:
bin/kafka-server-start.sh config/server/properties
▪ 停止集群:
bin/kafka-server-stop.sh
▪ 查看集群状态:
bin/kafka-broker-api-versions.sh --bootstrap-server node01:9092
• 主题管理
▪ 增:
bin/kafka-topics.sh --**create** --topic test-topic \
--partitions 3 \ #分区数
--replication-factor 2 \ #副本数
--bootstrap-server node01:9092
▪ 删:
bin/kafka-topics.sh --**delete** \
--topic test-topic --bootstrap-server node01:9092
▪ 改:
bin/kafka-topics.sh --**alter** \
--topic test-topic \
--partitions 6 --bootstrap-server node01:9092
#修改分区数量,副本数不可改
▪ 查:
查看主题详情:
bin/kafka-topics.sh --**describe** \
--topic test-topic --bootstrap node01:9092
查看主题列表:
bin/kafka-topics.sh --**list** --bootstrap-server node01:9092
生产者和消费者管理
• 生产者和消费者管理
▪ 生产者生产消息:
bin/kafka-console-producer.sh --topic test-topic --bootstrap-server node01:9092
▪ 消费者消费消息:
bin/kafka-console-consumer.sh --topic test-topic --from-beginning --bootstrap-server node01:9092
--from-beginning:把这个主题分区现在还保存着的全部历史消息一次性打印出来,然后继续监听新消息。
**坑:**
**消费者组提交过offset,就不会从头读历史消息**
▪ 查看消费偏移量:
首先要查看当前消费者属于哪个组,默认会创建
bin/kafka-consumer-groups.sh --list --bootstrap-server node01:9092
其次查看这个消费者的偏移量:
bin/kafka-consumer-groups.sh --describe \
--group console-consumer-49448 #组名
--bootstrap-server node01:9092
• 消费组管理
▪ 查看所有的消费组:
/bin/kafka-consumer-groups.sh --list --bootstrap-server node01:9092
▪ 查看消费组的详情信息:
创建消费组的时候,自动确认消费了,否则查看的信息显示-
bin/kafka-console-consumer.sh --topic test-topic \
--from-beginning --bootstrap-server node02:9092 \
--consumer-property enable.auto.commit=true
▪ 查看组的消息详情:
/bin/kafka-consumer-groups.sh --desctibe \
--group console-consumer-32495 --bootstrap-server node02:9092
**显示信息:**
CURRENT-OFFSET:当前消费者提交的偏移量
LOG-END-OFFSET:当前消息中最新的偏移量
LAG:滞后量,没有被消费者消费的数量**(运维最常看)**
• 副本和分区管理
kafka默认创建topic时,会自动根据broker数量分配副本。但实际生产中,我们常常要手动**重分配副本** ,以实现均衡或故障恢复
▶ 什么情况下会需要重分配副本:
1.新加节点
2.结点宕机
3.分区数量增加
▪ 第一步:生成副本迁移方案:
创建一个json文件 topics.json
{
"topics": [
{
"topic": "test-topic"
}
],
"version": 1
}
▪ 第二步:生成分配计划(只生成,不执行)
bin/kafka-reassign-partitions.sh \
--bootstrap-server node01:9092 \
--topics-to-move-json-file topics.json \
--broker-list "1,2,3" \ #3个节点id
--generate #生成
▪ 第三步:执行副本重分配
1.将上一步中"proposedAssignment"生成的方案复制成reassignment.json
2.执行副本迁移:
bin/kafka-reassign-partitions.sh \
--bootstrap-server node01:9092 \
--reassignment-json-file reassignment.json \
--execute #执行,运行
▪ 第四步:查看迁移状态
bin/kafka-reassign-partitions.sh \
--bootstrap-server node01:9092 \
--reassignment-json-file reassignment.json \
--verify #验证,核对
• leader失效
使用以下命令查看哪个分区的Leader发生故障:
bin/kafka-topics.sh --decribe --topic test-topic --bootstrap-server node01:9092
重新选举leader:
bin/kafka-leader-election.sh \
--bootstrap-server node01:9092 \
--election-type PREFERRED \ #表示选择“首选副本”作为新的Leader
--all-topic-partitions #对所有Topic的所有分区生效