ELK日志系统分析平台
先一句话总览:
**Elasticsearch是存数据+搜索的仓库;Filebeat是跑腿采集日志;Kibana是可视化看板。三者可以独立跑,但是搭ELK日志平台的时候,就是一套黄金搭档。**
1\. 每个rpm包是什么
① elasticsearch‑7.17.29‑x86_64.rpm
角色:数据库+搜索引擎(仓库)w
* 本质:一个特殊的数据库,专门擅长**快速搜索** 。
* 能干什么:接收日志、把日志存起来,你想查“昨天报错的日志”“某个IP访问记录”,它能秒搜出来。
* 就好比:**一个超大的、带快速检索功能的文件柜** 。
* 能不能独立运行:✅ **完全可以单独用** 。 很多业务只拿ES做搜索,比如网站商品搜索、APP全文检索,根本不用Filebeat、Kibana。
② filebeat‑7.17.29‑x86_64.rpm
角色:日志搬运工(采集客户端)
* 它**不存数据,也不能查数据** 。
* 任务:守在你的服务器上,盯着日志文件(nginx日志、java程序日志、系统日志),一有新日志就读取,然后发给 Elasticsearch(或者Logstash)。
* 大白话:**快递员,专门负责把日志包裹运送到仓库(ES)** 。
* 能不能独立运行:✅ 可以启动,但是单独跑它没有意义。 没有接收方,它采集了日志也无处可送。**它天生就是“采集端”,依附ES做目的地** 。
③ kibana‑7.17.29‑x86_64.rpm
角色:网页看板、操作控制台
* 它**本身不存任何日志数据** ,所有数据都来自 Elasticsearch。
* 给你一个浏览器网页界面:
* 搜日志、看报错;
* 画图表:请求量趋势、错误数量柱状图;
* 还能写DSL查询语句操作ES。
* 大白话:**仓库的前台显示屏,你透过屏幕查看柜子里的东西** 。
* 能不能独立运行:✅ 进程能启动,但是没任何数据。 一旦连不上Elasticsearch,Kibana就是一个空白页面,啥也干不了。
* * *
# 2\. 三者依赖关系(重点!)
谁依赖谁
1. **Filebeat → 必须发给 Elasticsearch** (采集→存储)
2. **Kibana → 必须连接 Elasticsearch** (看板读取ES的数据)
3. **Elasticsearch 谁都不靠,自己就能干活**
依赖链: Filebeat(搬运工) → Elasticsearch(仓库) ← Kibana(网页看板)
组合方案有好几种
1. **全套ELK方案(最常见):Filebeat + Elasticsearch + Kibana**
* Filebeat 在业务服务器上跑,捞日志;
* 送到ES存储;
* 你打开Kibana网页查看、搜索日志。
* 作用:**日志集中管理平台** ,所有服务器日志统一收集、检索、可视化。
2. **只装 Elasticsearch**
* 用来做搜索服务,业务程序直接读写ES,不需要日志采集、不需要看板。
3. **Elasticsearch + Kibana,不要Filebeat**
* 自己写程序把数据推送到ES,再用Kibana看数据。
4. **Filebeat单独装(很少这么用)**
* 只能采集,没有接收端,等于白跑。
* * *
# 3\. 实际能干出来什么效果(举运维场景例子)
比如你有3台web服务器:
* 每台服务器安装 **Filebeat** ,监控 Nginx、Java项目日志;
* 一台机器部署 **Elasticsearch** ,接收三台机器发来的所有日志;
* 同一台或另一台机器部署 **Kibana** ;
你打开浏览器访问Kibana网页:
1. 一下子看到三台服务器所有日志;
2. 一秒搜出包含 `Exception`、`error` 的报错日志;
3. 画出折线图看每分钟报错量;
4. 不用再一台台ssh登录服务器,挨个翻日志文件。
这就是大家常说的 **ELK / EFK 日志平台** 。
* * *
# 4\. 版本号7.17.29注意事项(大坑)
这三个包版本必须完全一模一样! Filebeat 7.17.29、ES 7.17.29、Kibana 7.17.29 版本不一致大概率连不上、报错。
* * *
# 极简总结表格
软件| 身份| 是否可独立运行| 核心作用
---|---|---|---
Elasticsearch| 日志仓库+搜索引擎| ✅ 独立| 存储、检索日志数据
Filebeat| 日志采集搬运工| ⚠️可启动但无意义| 读取服务器本地日志,推送给ES
Kibana| Web可视化看板| ⚠️可启动但无数据| 网页查看、搜索、图表展示ES里的数据
# 配置过程
• 前期部署:
1.准备虚拟机:2核4G
2.关闭防火墙、selinux(getenforce查看,setenforce 0临时关闭)
3.配置三台主机免密(方便传输文件)
4.集群时间同步chronyc
• 集群部署ES:
1.修改默认打开文件限制数:
vim /etc/security/limits.conf
添加:
#soft:软限制,用户可以修改 hard:硬限制,用户修改不了
* soft nofile 65535 #打开的文件数量
* hard nofile 65535
* soft nproc 65535 #打开的进程数量
* hard nproc 65535
#查看当前系统的可打开文件数量:
ulimit -n
#查看当前系统的可打开进程数量:
ulimit -u
2.修改内核参数:
vim /etc/sysctl.conf
最后添加如下内容:
vm.max_map_count=262144
配置虚拟内存的内存映射区数量
tips:同步数据到三个节点
3.修改配置文件:
vim /etc/elasticsearch/elasticsearch.yml
cluster.name: elk #集群名称
node.name: es-01 #指定节点的名称
path.data: /var/lib/elasticsearch #数据路径
path.logs: /var/log/elasticsearch #日志路径
network.host: 0.0.0.0 #ES服务监听的IP地址
discovery.seed_hosts: ["es-01","es-02","es-03"] #主机列表
cluster.initial_master_nodes: ["es-01","es-02","es-03"]
**#第一次启动时,谁有资格选主,仅第一次生效**
4.三台主机启动服务:
systemctl start elasticsearch
5.检查集群状态信息:
curl localhost:9200
curl localhost:9200/_cat/nodes
显示内容类似:
192.168.1.15 11 72 46 1.56 0.49 0.17 cdfhilmrstw * es-03
192.168.1.9 11 71 48 1.29 0.39 0.14 cdfhilmrstw - es-01
192.168.1.14 13 72 45 0.72 0.23 0.08 cdfhilmrstw - es-02
各个含义:
ip,堆内存JVM使用率,物理内存使用率,cpu使用率
1min系统负载,5分钟系统负载,15min系统负载
6.部署失败了,需要清除数据,排查出错之后,重新启动:
rm -rf /var/{lib,log}/elasticsearch/*
rm -rf /tmp/*
注意:
elasticsearch相关目录的权限,权限不对也会失败。
# ES数据模型相关概念
• 文档
最小数据单元:
以JSON格式存储的一条数据记录(如一条日志、一个商品信息)
• 索引
逻辑数据容器:
类似数据库中的“表”,存储具有相同结构的文档集合
特点:
▪ 索引名必须小写
▪ 支持动态映射
• 映射(mapping)
字段定义规则:
描述文档中各个字段的类型(如text、keyword、date)和属性(如是否分词、是否索引)
示例:
{
"mappings": {
"properties": {
"message": { "type": "text" },
"timestamp" : { "type": "date" }
}
}
}
• 字段数据类型
类型| 用途
---|---
text| 全文搜索(分词)
keyword| 精确匹配(不分词,如 ID、状态)
date| 日期和时间
long/integer| 数值类型
boolean| 布尔值
nested| 嵌套对象
# 集群架构相关概念
• 节点
▪ 单个ES示例:一个物理或虚拟服务器
• 集群
多个节点的集合,共用一个集群名称
• 分片(Shard)
▪ 数据分块:索引被水平拆分为多个分片,分散到不同节点
▪ 类型:
Primary Shard:主分片,处理写请求
Replica Shard:副本分片,提供读高可用
**主分片索引创建时自动分配,数量在创建索引时指定,后续不可修改。推荐主分片数量为节点总数。副本节点可后续动态调整。**
• 健康状态
状态值:
green:所有主分片和副本分片正常
yellow:主分片正常,副本分片未完全分配
red:存在主分片不可用
# 下载IK分词器
1.网上下载对应版本IK分词器
2.创建目录/usr/share/elasticsearch/plugins/ik
3.解压到目录
4.设置权限:
chown -R elasticsearch:elasticsearch /usr/share/elasticsearch/plugins/ik
5.重启elasticsearch,验证安装
curl -XGET http://localhost:9200/_cat/plugins?v
6.验证使用分词器
curl -XPOST "http://localhost:9200/_analyze" -H 'Content-Type: application/json' -d'
{
"analyzer": "ik_smart",
"text": "中华人民共和国"
}'
# 部署Kibana服务
1.本地安装kibana:
(1)下载对应版本的源码和rpm包
(2)安装kibana
yum -y install ./kibana-xxxx.rpm
2.修改配置文件
vim /etc/kibana/kibana.yml
server.host: "0.0.0.0"
server.name: "kibana-elk" #自己起名
elasticsearch.hosts: ["http://es-01:9200","http://es-02:9200",……] #集群
i18n.locale: "zh-CN" #中文
3.启动服务
systemctl start kibana
4.访问
http://IP:5601
# filebeat部署及基础使用
• 安装filebeat:
yum install -y filebeat-xxxx.rpm
• 修改filebeat的配置文件
1.标准输入:
vim /root/config/01.yml
filebeat.inputs:
- type: stdin #标准输入(用户终端输入)
output.console:
pretty: true #打印漂亮的格式
**运行filebeat示例:**
filebeat -e -c /root/config/01.yml
2.input的log类型:
vim /root/config/02.yml
filebeat.inputs:
- type: log #log类型,会监控指定路径的文件变化
paths:
- /tmp/test.log
output.console:
pretty: true
3.input通配符案例:
vim /root/config/03.yml
filebeat.inputs:
- type: log
paths:
- /tmp/*.txt #监控所有txt文件
- /tmp/*.log #监控所有log文件
output.console:
pretty: true
4.多input输入案例:
vim /root/config/04.yml
filebeat.inputs:
- type: log
enabled: true #是否启动当前的输入类型,默认是true
paths:
- /tmp/test.log
tags: ["linux-log"] #给当前的输入类型打上标签
**fields:**
pathID: "1001"
- type: log
enabled: false #代表当前的输入类型不启动,不监控
paths:
- /tmp/test.txt
tags: ["linux-txt"]
fields:
pathID: "1002"
**fields_under_root: true**
output.console:
pretty: true
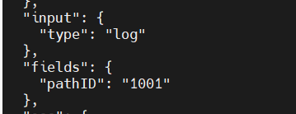
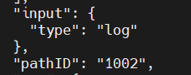
**fields_under_root:**
**将定义字段的值放到顶级字段,默认值为false,会将数据放在一个叫 "fields"字段的下面**
**默认输出:**
**" fields": {**
**" pathID": "1001"**
**}**
**配置后的输出:**
**" pathID" : "1001"**
5.将捕获的数据写入ES:
output.elasticsearch:
hosts:
- http://es-01:9200
- http://es-02:9200
- http://es-03:9200
6.自定义分配和副本数量
indices: #动态索引路由列表,给日志走“分流”规则,不容标签的日志进入不同索引
- index: "index-linux-elk-%{+yyyy.MM.dd}" #第一条分流规则
when.contains:
tags: "linux80" #如果这条日志tags字段数组里面包含了linux80,就命中上面这条索引规则
- index: "index-linux-elk-%{+yyyy.MM.dd}" #第二条分流规则
when.contains:
tags: "python"
setup.ilm.enabled: false #禁用索引生命周期管理
setup.template.name: "index" #设置索引模板的名称
setup.template.pattern: "index-*" #设置索引模板匹配模式
setup.template.overwrite: true
#每次filebeat启动的时候,如果ES里面已经存在同名模板index,就强制覆盖更新模板配置
setup.template.settings: #索引模板的参数配置块
index.number_of_shards: 3 #主分片数量
index.number_of_replicas: 2 #副本分片数量