8.10 文本三剑客
• cat !$:上一条命令的参数(文件地址)
• 正则表达式:
\:转义符 ^:以……开头
$:以……结尾 .:匹配除换行符以外的任意单个字符
[]:匹配包含在[ ]之中的任意一个字符
[^]:匹配[ ]之外的任意一个字符
[-]:匹配[ ]中指定范围内的任意一个字符 [0-9]
?:匹配之前的项1次或0次 aa?---->a aa
+:匹配之前的项1次或多次 aa+----->aa aaa aaaa aaaaaa
*:匹配之前的项0次或多次 aa*------->a aa aaa aaaa
():创建一个用于匹配的子串 ma(tri)?------>ma matri
{n}:匹配之前的项n次 [0-9]{3}------>三个数字
{n,}:之前的项至少需要匹配n次 [0-9]{3,}------->三个数字或更多
{n,m}:之前的项至少匹配n次,至多m次 [0-9]{3,5}----->三个数字到五个数字
|:匹配两边的任意一项 ab(c|d)---------->abc或abd
▶ grep
• grep -r:递归查找子目录下文件
• grep -i:忽略大小写
• grep -n:显示行号
• egrep\grep -E:使用正则表达式
• grep -v:反向匹配
▶ sed
增:
▪ sed '1a\Welcome' a.txt 第1行后追加一行
▪ sed '1i\Welcome' a.txt 第1行前插入一行
▪ sed '/Pony/a\Welcome' a.txt 匹配到的行后追加一行
▪ sed -e '/^$/d' -e '/Pony/d' a.txt 删除空行和Pony那行 -e多个条件
▪ sed '/^$/d; /Pony/d' a.txt 与-e作用相同
删:
▪ sed '2,3d' a.txt 删除2到3行
▪ sed '/Pony/d' a.txt 删除匹配到的行
▪ sed '/^$/d' a.txt 删除空白行
改:
▪ sed 's/Jack/Mark/' a.txt:替换文本 g全部替换
▪ sed '2,3s/hello/Hey/g' a.txt 将2到3行文本全部替换
▪ sed '/Pony/s/hello/Hi/g' a.txt 匹配到Pony,把那行替换 !s没有的替换
▪ sed -i.bak '/^$/d' a.txt 修改后文件会保存,-i.bak会备份
查:
sed -n '/Pony/p' a.txt 打印匹配行,-n和p需要同时使用
▶ sed高级用法:
• 交换两列的内容:
echo "Alice 30" | sed -r 's/(.*) (.*)/\2 \2/'
▶ awk awk [选项] '[条件]{指令}' 文件
• awk常用内置变量:
$0:文本当前行的全部内容 $1第一列 $2第二列……
NR:文件当前行的行号
NF:文件当前行的列数
• 指定分隔符为:
awk -F: '/^bin/{print}' user
• 指定分隔符为:,并打印第六列和行号还有列数:
awk -F: '/^bin/{print $6,NR,NF}' user
• 指定分隔符为:,并打印第六行列和行号还有最后一列内容:
awk -F: '/^bin/{print $6,Nr,$NF}' user
• 指定多个分隔符,当两个同时出现时,认为是一个分隔符:
awk -F '[:/]' '/^bin/{print $1,$3}' user
tips:当数据是a:aa:/bb/cc,输出结果为a bb
• 格式化输出:
awk会逐行处理文本,支持在处理第一行之前做一些准备工作(BEGIN),以及在处理完最后一行之后做一些总结性质的工作(END)。
例子:
格式化输出/etc/passwd:
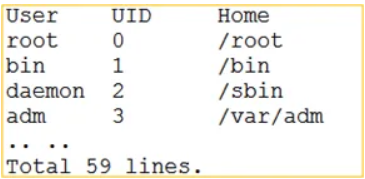
\t:表示Tab制表位
第一步:输出表头信息
awk 'BEGIN{print "User\tUID\tHome"}'
第二步:输出内容
awk -F: '{print $1"\t"$3"\t"$6}' user
第三步:输出结尾
awk 'END{print "总计 "NR" 行 "}' user
合在一起:
awk -F: 'BEGIN{print "User/tUID/tHome"}{print $1"\t"$3"\t"$6}END{print "Total "NR" Lines."}' /etc/passwd
• 使用正则设置条件
▪ ~包含 !~不包含
输出第六列包含root的行:
awk -F: '$6~/root/{print}' user
• 使用数值/字符串比较设置条件
=等于 !=不等于 >大于
• 多个逻辑条件
&& 与 || 或
• awk数组:
统计单词数量
echo "apple orange banana apple orange" | awk'
{
for(i=1;i<=NF;i++) count[$i]++
}
END{
for(word in count) print word,count[word]
}'
tips:$i表示第i个字段(如$1="apple",$2="orange")
count[$i]++使用单词作为数组count的下标,并递增其值